NBS: диск ВМ, который переживёт отказ сервера
Теперь nos хранит диск виртуальной машины сразу на трёх хостах. Как NBS режет том на чанки, что хранит Raft, а что нет, что происходит при отказе хоста и как этим пользоваться из панели и из командной строки.
До этого месяца диск ВМ в nos был файлом на том хосте, где работала машина, или разделом его NVMe. Это просто и быстро, но если хост умирает, машина умирает вместе с ним. Запустить её снова можно, только когда хост вернётся, и только если уцелел диск.
NBS мы сделали, чтобы это исправить. Это реплицируемое блочное хранилище: диск ВМ становится томом, том режется на чанки по 4 МиБ, и каждый чанк хранится на трёх хостах. Если один из них падает, машина продолжает работать на двух оставшихся копиях. Если падает хост самой машины, её запускают на другом хосте, и диск там уже есть.
Задача, как её записали 5 ноября, звучала так: сетевое блочное хранилище для nos, для дисков ВМ, образов и снимков, три реплики, Raft, и каждый сервис в виде модуля ядра. Всё написано с нуля на Rust поверх того, что в nos уже было: шифрованных каналов между хостами, реестра кластера и библиотеки Raft.
Начали с трёх серверов
Для трёх реплик нужны три хоста, а для большинства в Raft три голосующих. Серверов у нас было два: Hetzner EX44, на котором работает nos, и AX41 с Ubuntu. Так что третий хост получился с небольшой хитростью. На AX41 под KVM работают две ВМ с nos, и каждая из них считается хостом кластера, как и сам EX44. Все цифры ниже сняты на этой схеме, через гигабитный канал EX44.
Что работает на каждом хосте
Каждый хост загружает четыре модуля. ipcnet.ko связывает хосты между собой: у каждой пары два TCP-соединения, оба под TLS 1.3, и каждая сторона заранее знает ключ другой. cluster.ko ведёт реестр кластера, то есть список хостов с их ключами и адресами, и NBS не станет разговаривать с хостом, которого в реестре нет. Своего порта у NBS нет. Две его службы, nbs.mds и nbs.cs, просто зарегистрированы как имена в канале сообщений nos.
nbs-mds.ko отвечает за метаданные. Каждый хост держит всё состояние целиком, в памяти и на своём диске, а Raft следит, чтобы копии совпадали. nbs-cs.ko работает сервером чанков. Он владеет устройствами, которые хост отдал под NBS, разделом или целым диском, и хранит на них чанки в собственном формате.
А клиент вообще не служба. Это библиотека внутри модуля гипервизора, поэтому когда гостевая система читает или пишет свой диск, запрос идёт из hv прямо на серверы чанков, где лежат данные:
write   client on A --> cs on A --> cs on B --> cs on C
read    client on A --> cs on A
meta    mds on A <== Raft ==> mds on B <== Raft ==> mds on C
Сервис метаданных спрашивают, где лежат чанки, когда том подключают и когда что-то меняется, но никогда на каждый запрос. Это было одно из первых решений, и потом оно окупилось: что бы ни случилось с сервисом метаданных, уже подключённый диск продолжает работать.
Тома, чанки и наборы реплик
У тома есть имя, размер до 16 ТиБ, свой хост (обычно тот, где работает его ВМ) и карта, в которой по записи на каждый чанк в 4 МиБ. Чанки сгруппированы в наборы реплик. Набор состоит из трёх серверов чанков на трёх разных хостах, и все чанки, которые легли на одни и те же три хоста, делят один набор. Когда хост теряется, меняются только те немногие наборы, в которые он входит, а не каждый чанк, который на нём лежал.
Чанки размещаются при создании тома, внутри шага apply у Raft и только по уже закоммиченному состоянию, поэтому каждый хост приходит к одному и тому же ответу, ни с кем не советуясь. Одна реплика ложится на собственный хост тома, чтобы чтение оставалось локальным. Две другие уходят на хосты, где больше всего свободного места. Весь размер резервируется сразу, а чанк, в который ещё не писали, читается нулями и места на диске не занимает. Если хостов четыре и больше, NBS ещё и держит в запасе место, чтобы восстановить самый большой хост, и откажет тому, который в этот запас залезет.
В Raft хранится немного: участники, хосты и их устройства, тома, наборы и чанки. Чанк обходится в 12 байт памяти плюс 4 за каждое место в картах, которое на него указывает, и в сумме выходит около 4 МиБ кучи на терабайт томов. То, что меняется постоянно, в Raft не пишется намеренно. Жив ли хост, насколько заполнено устройство, сколько идёт ввода-вывода, в журнал не попадает никогда.
Как запись добирается до трёх дисков
У тома в каждый момент один писатель: хост, чья ВМ этот том подключила. При подключении писатель получает новый номер поколения, и каждый сервер чанков ставит на том барьер с этим поколением, прежде чем ответить. ВМ, запущенная заново на другом хосте, получает поколение новее, поэтому поздние записи старого хоста отвергаются, даже если он вернётся к жизни с запросами в полёте.
Запись считается выполненной, когда её получили все реплики набора. В первой версии хост-писатель отправлял каждую запись всем трём репликам сам. На гигабитном канале это значит, что на каждый записанный байт с хоста уходят две копии, и запись упиралась примерно в 55 МиБ/с. Теперь запись идёт по цепочке. Данные покидают писателя один раз, уходят в локальную реплику, та передаёт их второй, вторая третьей, и каждая реплика отвечает писателю сама. Если следующее звено не ответило через 0,25 с после предыдущего, данные шлют ему напрямую. Запись с глубиной очереди выросла с 56 до 84-91 МиБ/с, это почти всё, что тянет канал.
Одиночные записи от цепочки, правда, стали медленнее. При глубине очереди 1 каждое звено должно получить кусок целиком, прежде чем передать его дальше, и запись по 256 КиБ упала с 25 до 11-15 МиБ/с. Поэтому запись, которая сейчас в полёте одна, отправляется всем трём репликам сразу, а цепочка работает только тогда, когда записей несколько, ради чего её и делали. После этого запись по 4 КиБ при глубине 1 ускорилась с 0,73 мс до 0,51 мс, а запись по 256 КиБ с 25 до 47 МиБ/с.
Чтение идёт в одну реплику, локальную, если она есть, и в другую, если та молчит. Данные надёжно сохранены после того, как гость сделает flush, как и с обычным диском: на flush отвечают, когда все реплики надёжно записали всё, что было до него.
Когда что-то ломается
На эту часть ушло больше всего времени.
Если реплика не ответила на запись за 0,5 с, писатель сообщает об этом лидеру метаданных. Лидер не верит писателю на слово. Он сам пингует сервер чанков с таймаутом 250 мс и убирает его из набора, только если тот не ответил и ему. После этого запись продолжается на две оставшиеся реплики. Второе мнение нужно потому, что иначе писатель со сломанной собственной сетью выкинул бы здоровые серверы из наборов, которыми пользуются и другие тома. Последнюю живую реплику набора не убирают никогда, записи её ждут.
Кроме того, лидер сам следит за каждым сервером чанков. Тот, кто молчит 5 с, помечается упавшим. Если он пролежал так 10 минут (параметр out_after), его объявляют выбывшим, а его места в наборах отдают другим хостам, и те копируют данные к себе. Когда хостов ровно три, копировать некуда, и том живёт на двух репликах, пока хост не вернётся. Чтобы NBS сам восстановил третью копию, нужен четвёртый хост.
Вернувшийся хост не копирует всё подряд. Он сверяет контрольные суммы своих чанков со здоровой репликой и забирает только то, что поменялось без него. В одном тесте мы убили хост посреди записи по 4 КиБ с глубиной 8. Самая долгая запись заняла 779 мс: 0,5 с писателя, пинг лидера и коммит в Raft. Дальше записи пошли на две реплики. Когда хост загрузился снова, он забрал 16 чанков, записанных за это время, сверил по суммам остальные 2032 и стал полноправным участником через 86 с после начала загрузки. В другом тесте хост потеряли насовсем, а четвёртый стоял наготове. Упавшим его пометили через 16 с, выбывшим через 10 мин 13 с, четвёртый хост скопировал его 8 ГиБ за 184 с, и через 13 мин 21 с после отказа каждый чанк снова был на трёх репликах.
Если умирает лидер метаданных, Raft выбирает нового, и больше никто ничего не замечает, потому что данные через сервис метаданных не ходят. Если большинства нет вообще, ничего нельзя ни поменять, ни починить, но уже подключённые тома продолжают работать. При разделении сети меньшинство ничего не коммитит. Писатель на стороне меньшинства работает, пока достаёт до всех своих реплик и ему не нужно ничего менять, а иначе ждёт. Там, где пришлось выбирать, мы выбрали сохранность данных, а не доступность.
Отключение питания берёт на себя сервер чанков. Каждая запись в его служебных таблицах делается дважды: копия A, flush, потом копия B. Барьеры и отметки о том, что чанк открыт на запись, становятся надёжными до того, как сервер ответит. Если писатель умер посреди записи, при следующем подключении открытые чанки сверяются, и данные копируются с одной реплики на остальные, пока все три не совпадут. А если хост ВМ потерян насовсем, hv start <name> force забирает её тома на другой хост с новым поколением, и старый хост оказывается за барьером.
Две вещи мы намеренно оставили человеку. Первая касается порчи данных на диске. Фоновая проверка читает реплики каждого чанка кусками по 64 КиБ, сравнивает CRC32C, смотрит дважды с интервалом в две секунды, чтобы не принять идущую запись за порчу, и сообщает о реплике, которая отличается от двух других. В первом варианте проверка сама выводила отличающуюся реплику из строя. Фаззер показал, почему это плохая идея: подключающийся хост скопировал данные с источника, который уже успел испортиться, две реплики сошлись на плохих данных, и проверка выключила единственную хорошую копию. Сервер чанков не хранит контрольных сумм своих данных, так что две совпадающие копии ничего не доказывают. Теперь проверка только сообщает, а nbs replica bad <set> <host> выводит реплику из строя, когда человек посмотрел сам. Вторая касается разошедшегося состояния. Раз в 64 записи журнала каждый участник сравнивает SHA-256 своего состояния с лидерским, и тот, у кого оно отличается, останавливается, а не раздаёт неверные метаданные.
Снимки, образы и клоны
Снимок подключённого тома делается на хосте писателя: писатель ставит запись на паузу, закрывает все чанки, в которые писал, и отвечает. Места снимок поначалу не занимает. Образом называется том, замороженный навсегда и доступный только для чтения. Новые тома клонируются из образов и снимков, тоже без копирования, поэтому ВМ из образа на 3 ГиБ поначалу стоит только метаданных. Первая запись в чанк, который клон ещё делит с образом, копирует этот чанк на собственном устройстве каждой реплики, и запись идёт уже в копию.
Как мы это проверяли
Большая часть NBS обходится без ядра. Машина состояний метаданных, движок сервера чанков, формат сообщений и клиент написаны как обычные крейты на Rust, и тот же код работает и в ядре, и в фаззере на ноутбуке. Цель cluster в фаззере гоняет серверы чанков и участников метаданных шести хостов по имитации сети, роняет хосты, передаёт лидерство и проверяет, что всё записанное читается обратно. Другие цели отключают питание серверу чанков посреди записи, с запросами в полёте и пока подключающийся хост копирует данные. Сверху ещё 275 мутантов. Каждый убирает из кода одно правило, проверку, барьер или таймаут, и фаззер должен это заметить. Ловятся все, кроме трёх, и эти три записаны как известные дыры.
Нашёл фаззер не всё. Две проблемы проявились только на настоящих серверах. Первая случалась, когда останавливалась занятая ВМ. При остановке закрываются все чанки, в которые она писала, а каждое закрытие требует двух записей служебной таблицы и двух flush. При flush в 10 мс, как у диска ВМ, 140 закрытий превращались в секунды очереди на сервере чанков. Пинг лидера с его 250 мс стоял в той же очереди, здоровые реплики выводились из строя, и 2,6 ГБ копировались заново просто так. Теперь сервер чанков отвечает на пинг вне очереди, а позже его переписали так, что в полёте может быть до 64 запросов, а служебные записи пишутся пачками. 1024 закрытия теперь укладываются меньше чем в секунду.
Вторая проблема была в том, что клиент отправлял слишком много сразу. Гость держит в полёте до 64 запросов по 248 КиБ, а это больше, чем канал между двумя хостами готов держать в очереди. Остальное отскакивало, через 200 мс уходило снова и снова отскакивало. На демостенде запись при этом шла 1,5 с на скорости 10 МиБ/с. Теперь клиент держит в полёте не больше 2 МиБ на том. Отскоков было 1036 за 15 секунд, а стало ноль, и самые медленные записи ускорились с 1,4 с до 0,25 с.
Чтобы проверить всё вместе, nbs-test.py поднимает три nos под QEMU и прогоняет 245 проверок на настоящих модулях, а hv-nbs-test.py запускает гостевые Linux на томах, в том числе со снимком работающей ВМ и второй машиной, загруженной из него.
Цифры
Сняты между EX44 и двумя ВМ на AX41 через гигабитный канал, на томе в 8 ГиБ. Исключение составляют записи при глубине 1: их мерили на трёх ВМ на AX41.
| Что | Результат |
|---|---|
| Чтение по 4 КиБ, глубина 8 и больше | 47-50 тысяч IOPS |
| Чтение по 256 КиБ, глубина 8 | 1,5-1,6 ГиБ/с |
| Запись по 256 КиБ, глубина 8-16 | 84-91 МиБ/с |
| Запись по 4 КиБ, глубина 1 | около 2000 IOPS (0,51 мс) |
| Запись по 256 КиБ, глубина 1 | 47-48 МиБ/с |
| Первая запись в новый чанк, p99 | 1,3-5,6 мс |
Чтение идёт из локальной реплики, так что работает почти на скорости устройства. Запись упирается в сеть. Эти цифры снимали, когда каналы между хостами ещё шифровались переносимым кодом на Rust. С 16 ноября там ChaCha20-Poly1305 на ассемблере CRYPTOGAMS, который на единственной машине, где мы его мерили, шифрует в 3,7 раза быстрее. NBS после этого заново не мерили.
Как пользоваться из панели
На странице каждого хоста в панели управления есть раздел «Блочное хранилище». На новом кластере там будет кнопка «Создать кластер NBS». Потом через «Добавить хост» добавляются остальные хосты, когда реестр кластера уже о них знает (это делается в разделе «Кластер» кнопками «Создать кластер», «Пригласить хост» и «Войти в кластер»), а каждый хост получает своё хранилище через «Добавить устройство», то есть раздел или целый диск, выбранный по идентификатору. Дальше страница показывает, на что обратить внимание в первую очередь (упавший сервер чанков, чанки на двух репликах, нет лидера), затем тома с их состоянием зелёным, жёлтым, оранжевым или красным, серверы чанков, участников и устройства. У каждого тома есть «Увеличить», «Снимок», «Клонировать», «Сделать образом» и «Удалить». Для удаления и превращения в образ панель просит ввести имя ещё раз.
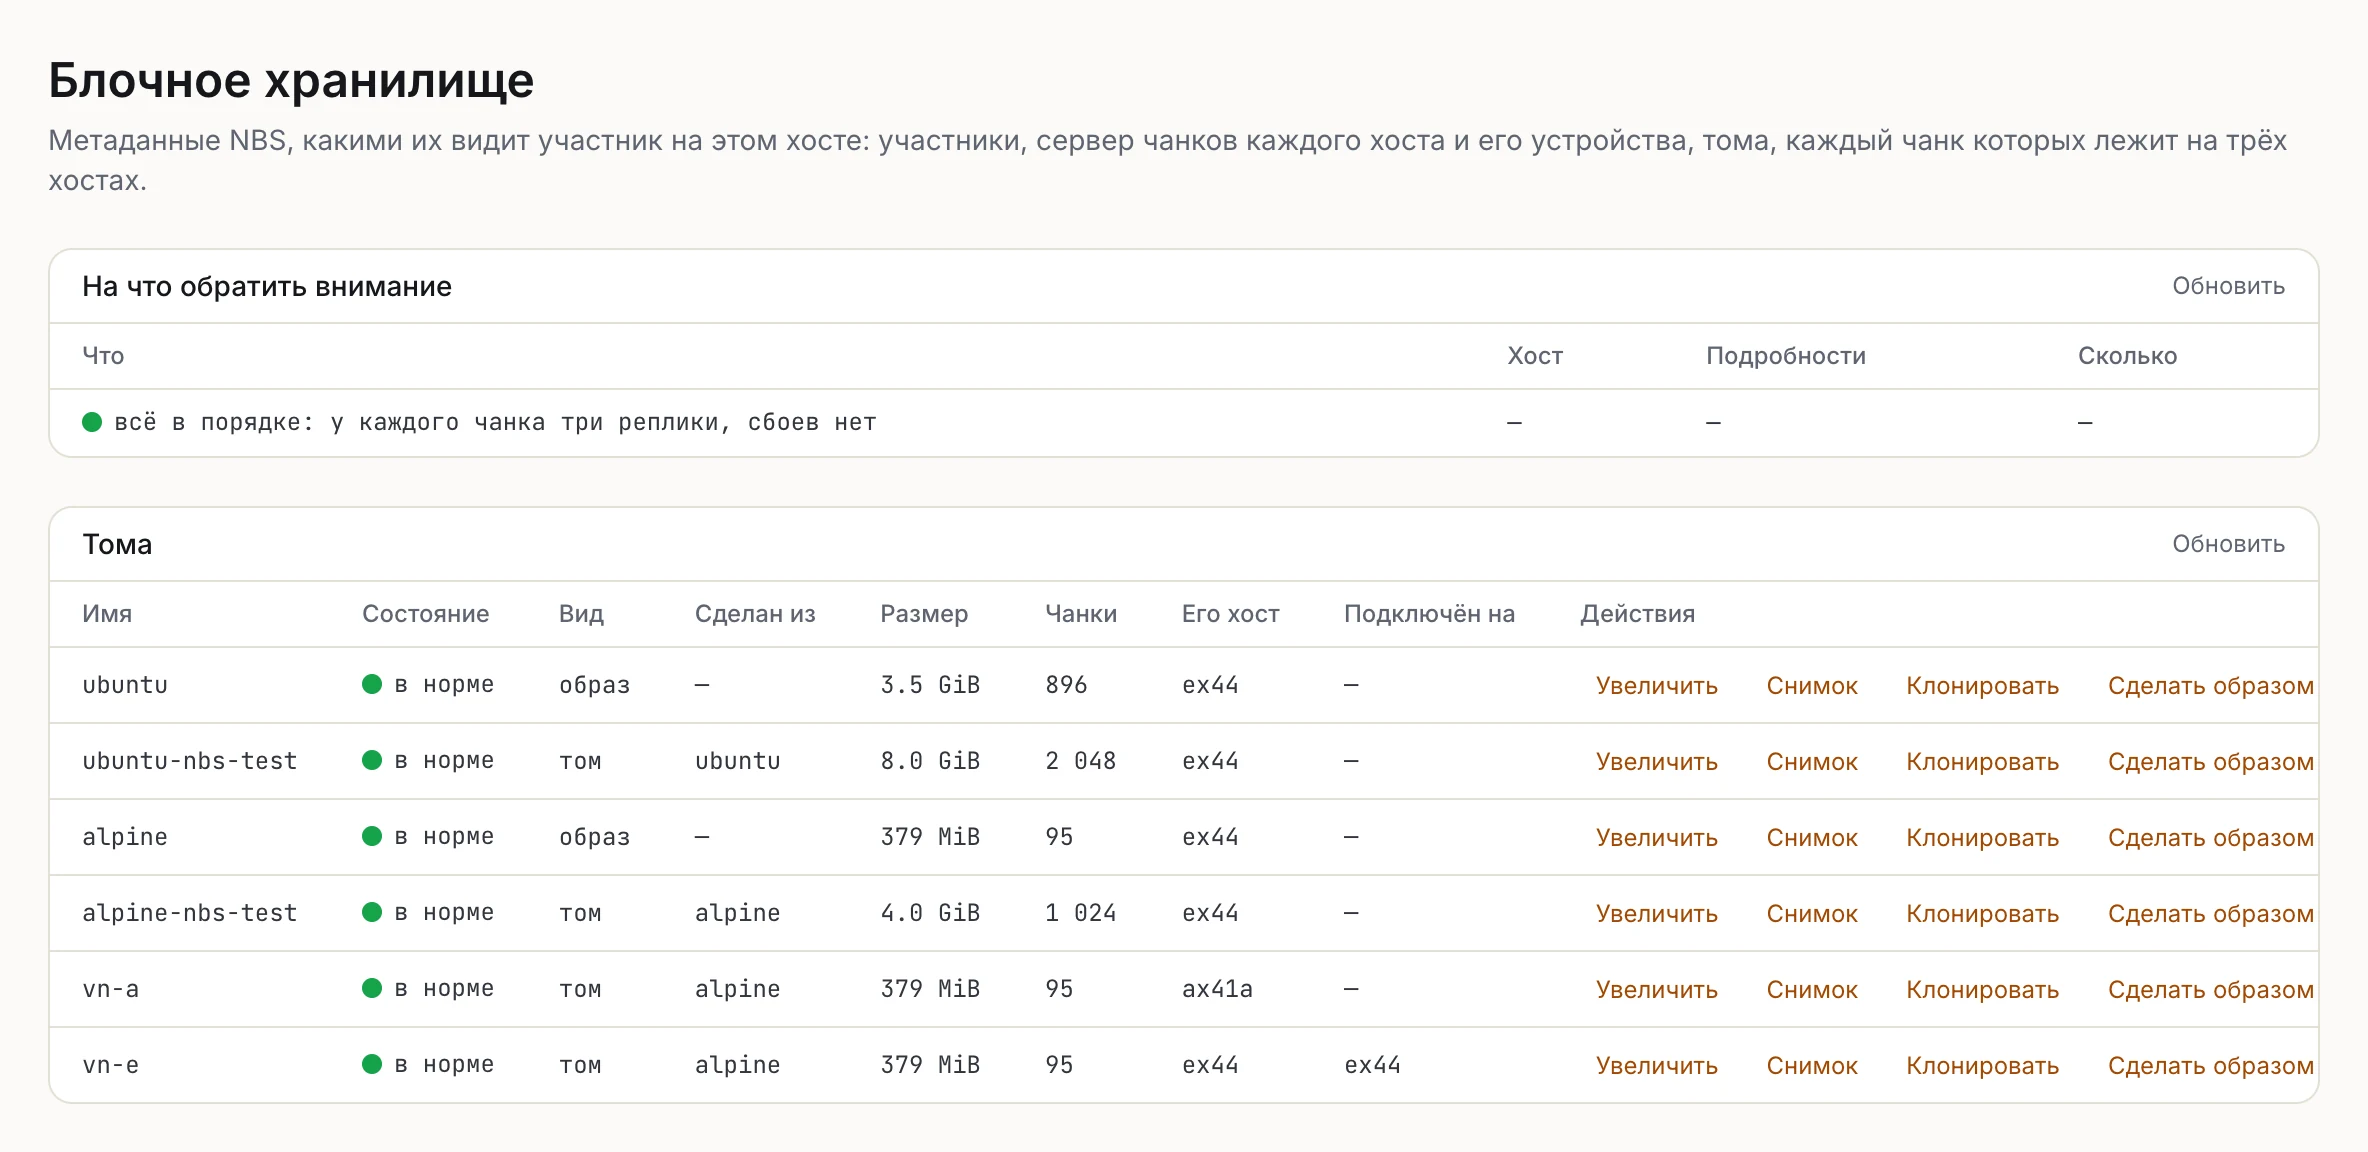
Страница «Блочное хранилище» на EX44. У каждого чанка три реплики. ubuntu и alpine здесь образы, а четыре тома склонированы из них; vn-e подключён на EX44, где работает его ВМ.
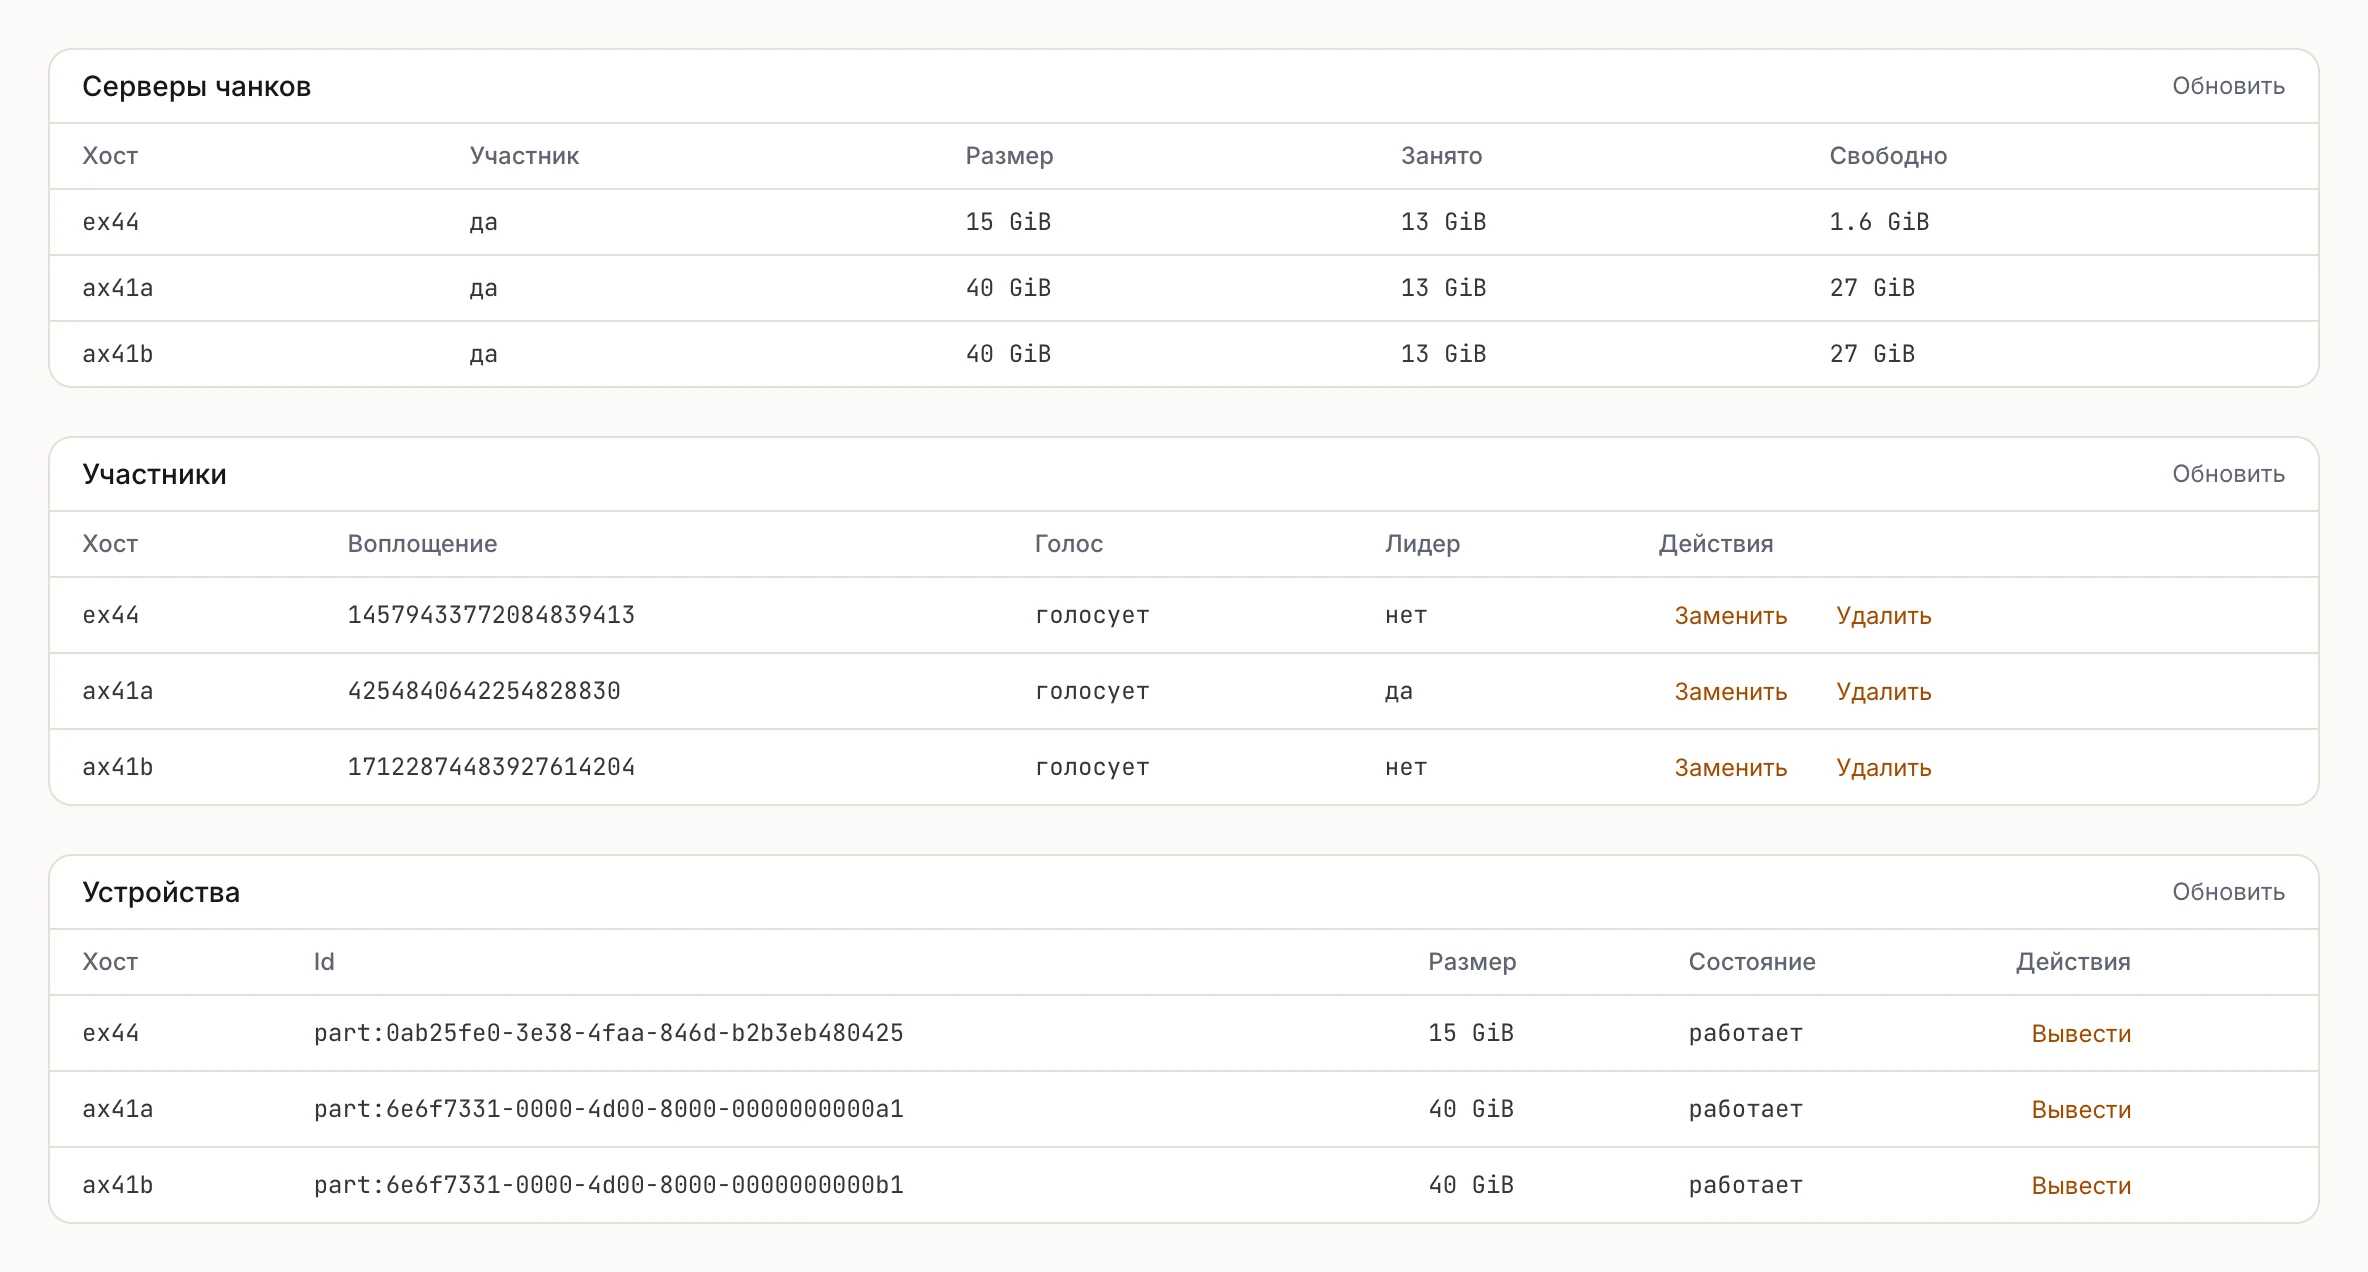
Ниже: сервер чанков на каждом хосте, у EX44 на разделе в 15 ГиБ, у двух ВМ по 40 ГиБ, три участника, где лидирует ax41a, и устройства по идентификаторам разделов.
На странице «Образы» перечислены образы и снимки NBS. «Новый образ» принимает URL, а облачные образы Debian 13 и Ubuntu 24.04 выбираются в один клик. Хост скачивает образ, записывает его на новый том и замораживает.
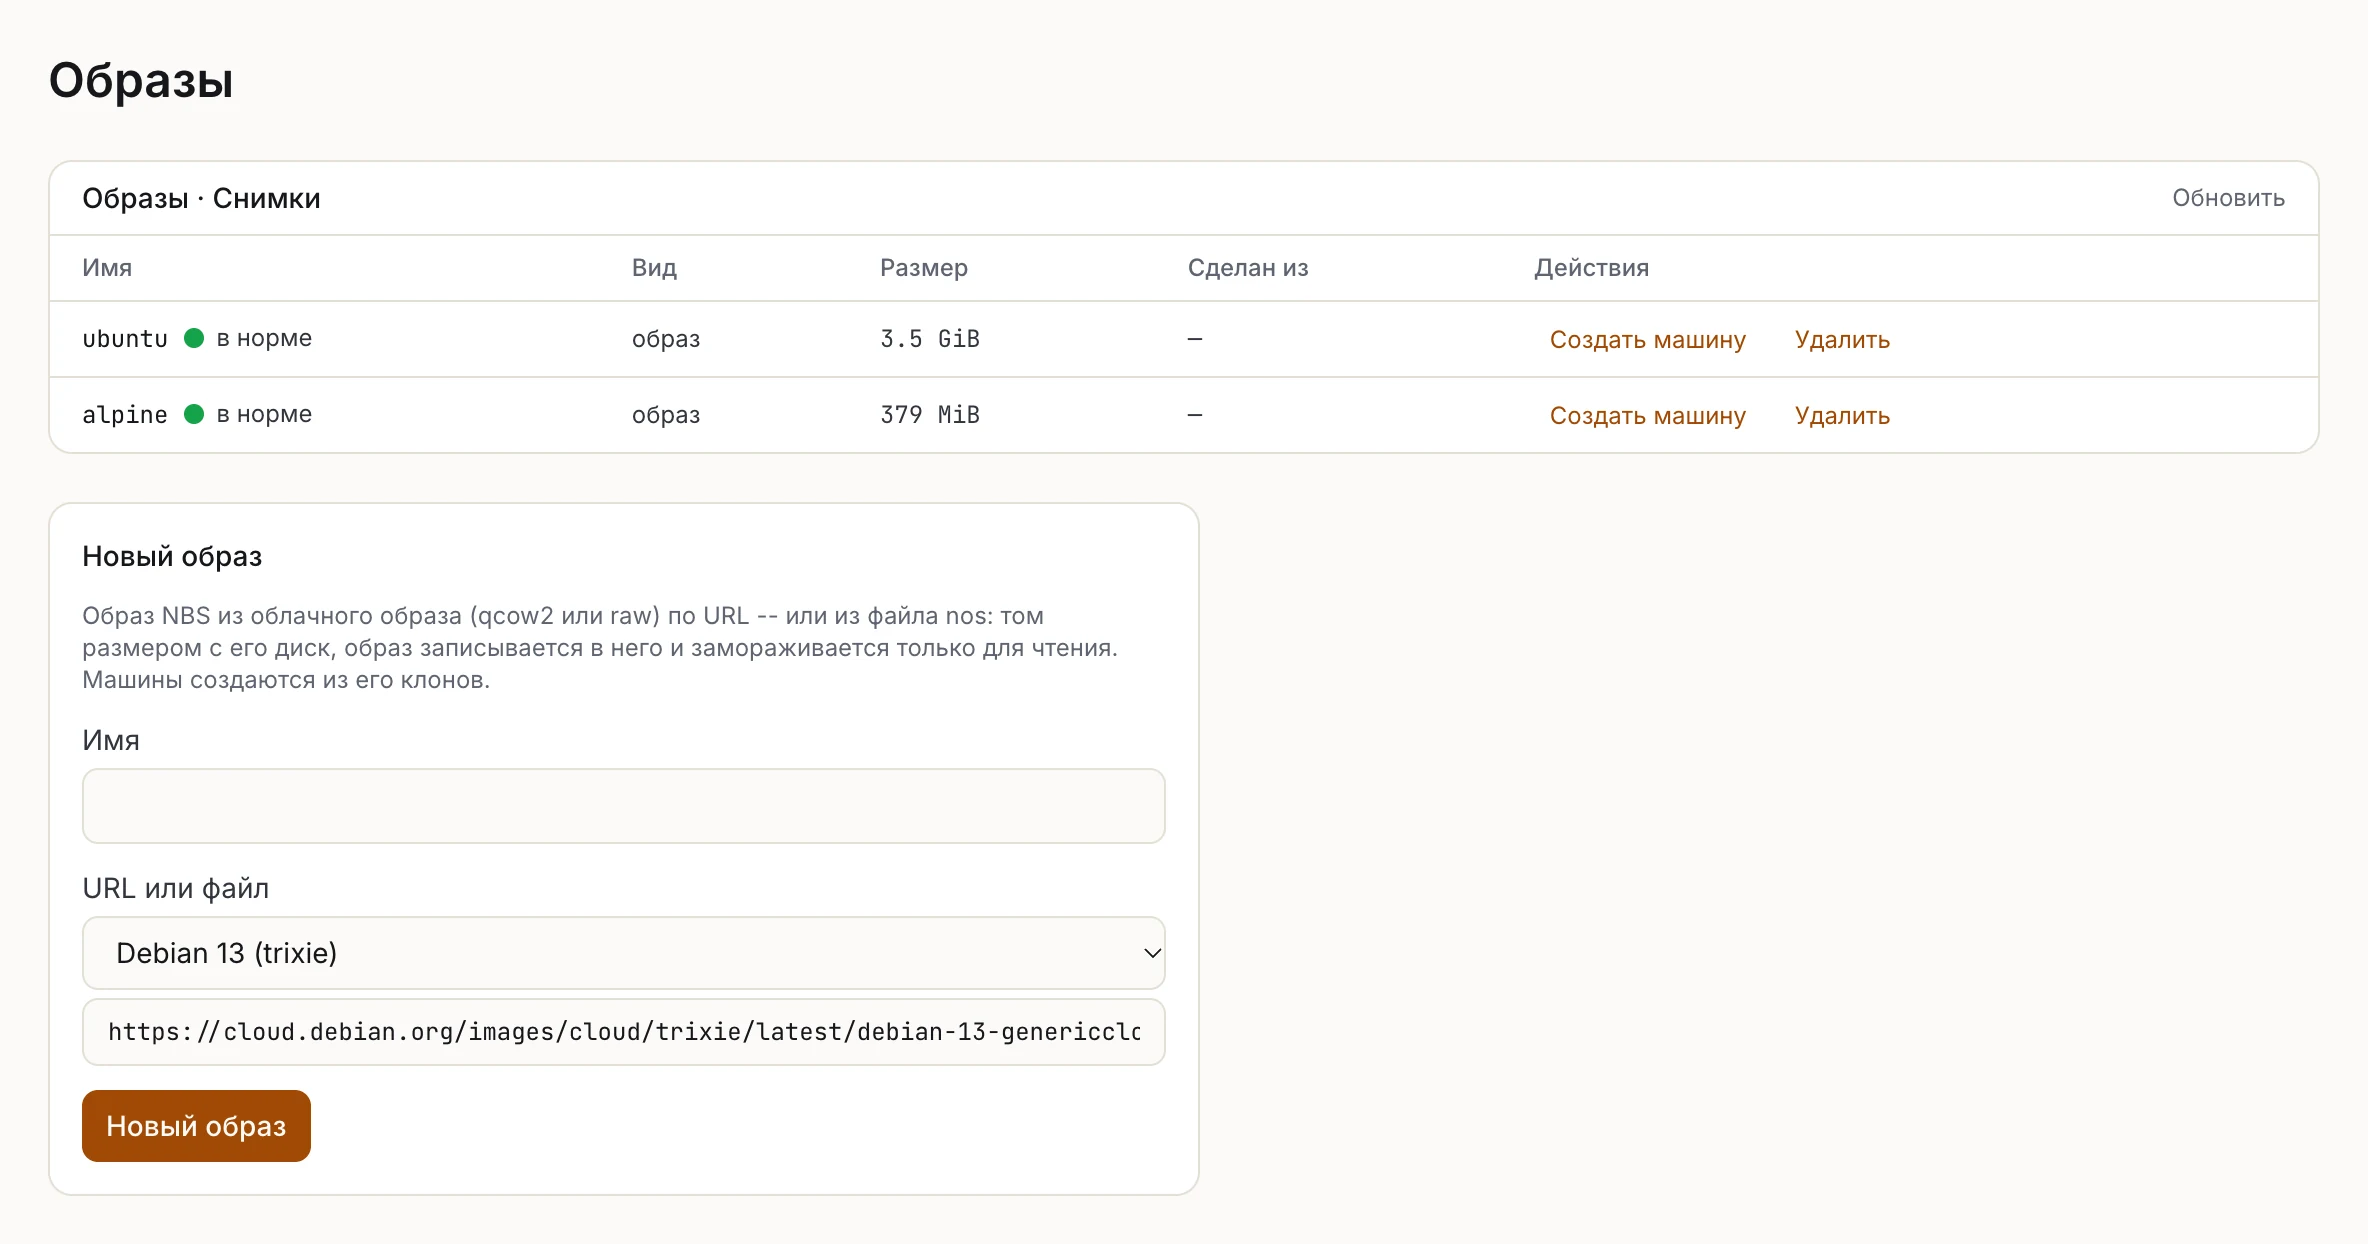
Страница «Образы»: два образа и форма, которая делает новый по URL облачного образа.
«Создать машину» в строке образа или «Образ NBS» в качестве источника в форме новой ВМ создают машину, чей диск будет тонким клоном этого образа.
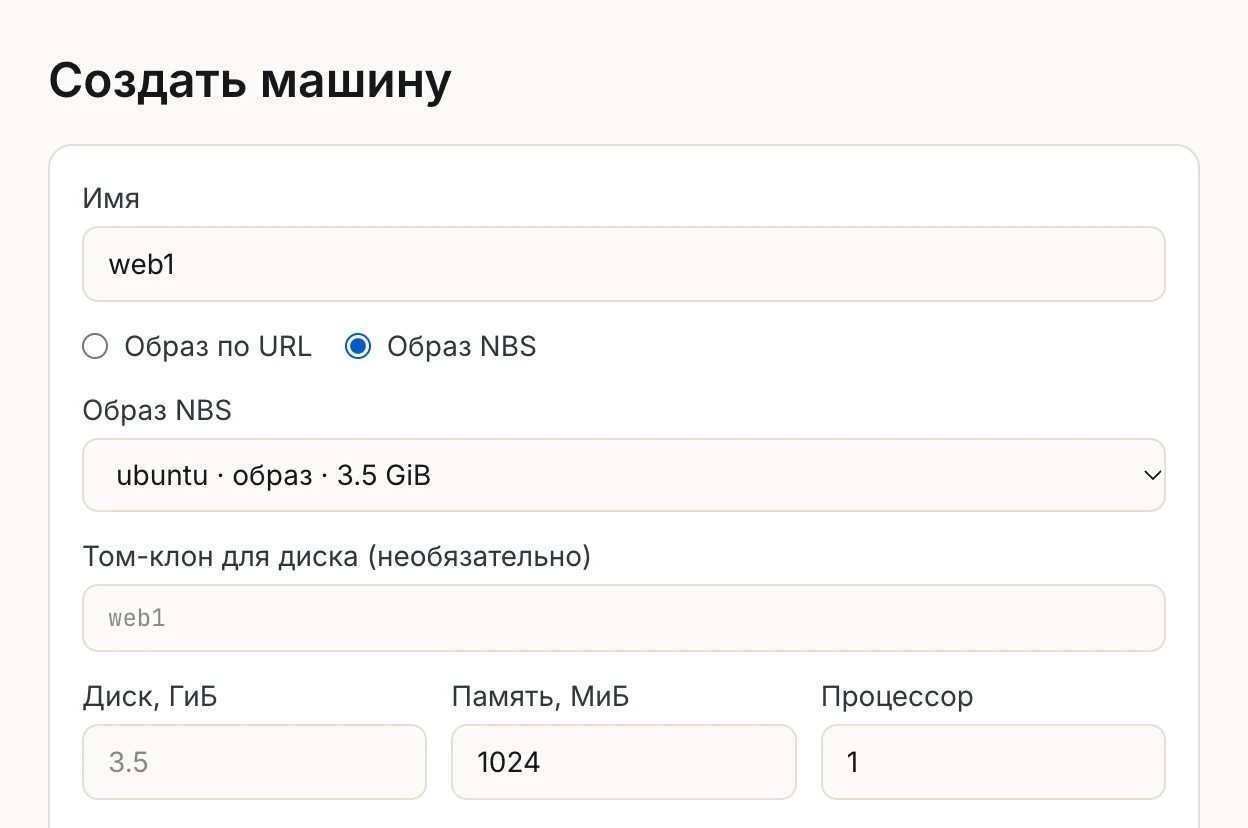
Форма новой ВМ с образом NBS в качестве источника. Клон называется так же, как машина, если не дать ему своё имя.
На странице самой ВМ есть действие «Снимок» и список её снимков, у каждого своя кнопка «Создать машину», а вкладка «Диски» рисует IOPS и пропускную способность каждого диска, подсвечивает его жёлтым при росте задержки и красным при ошибках и показывает рядом состояние тома.
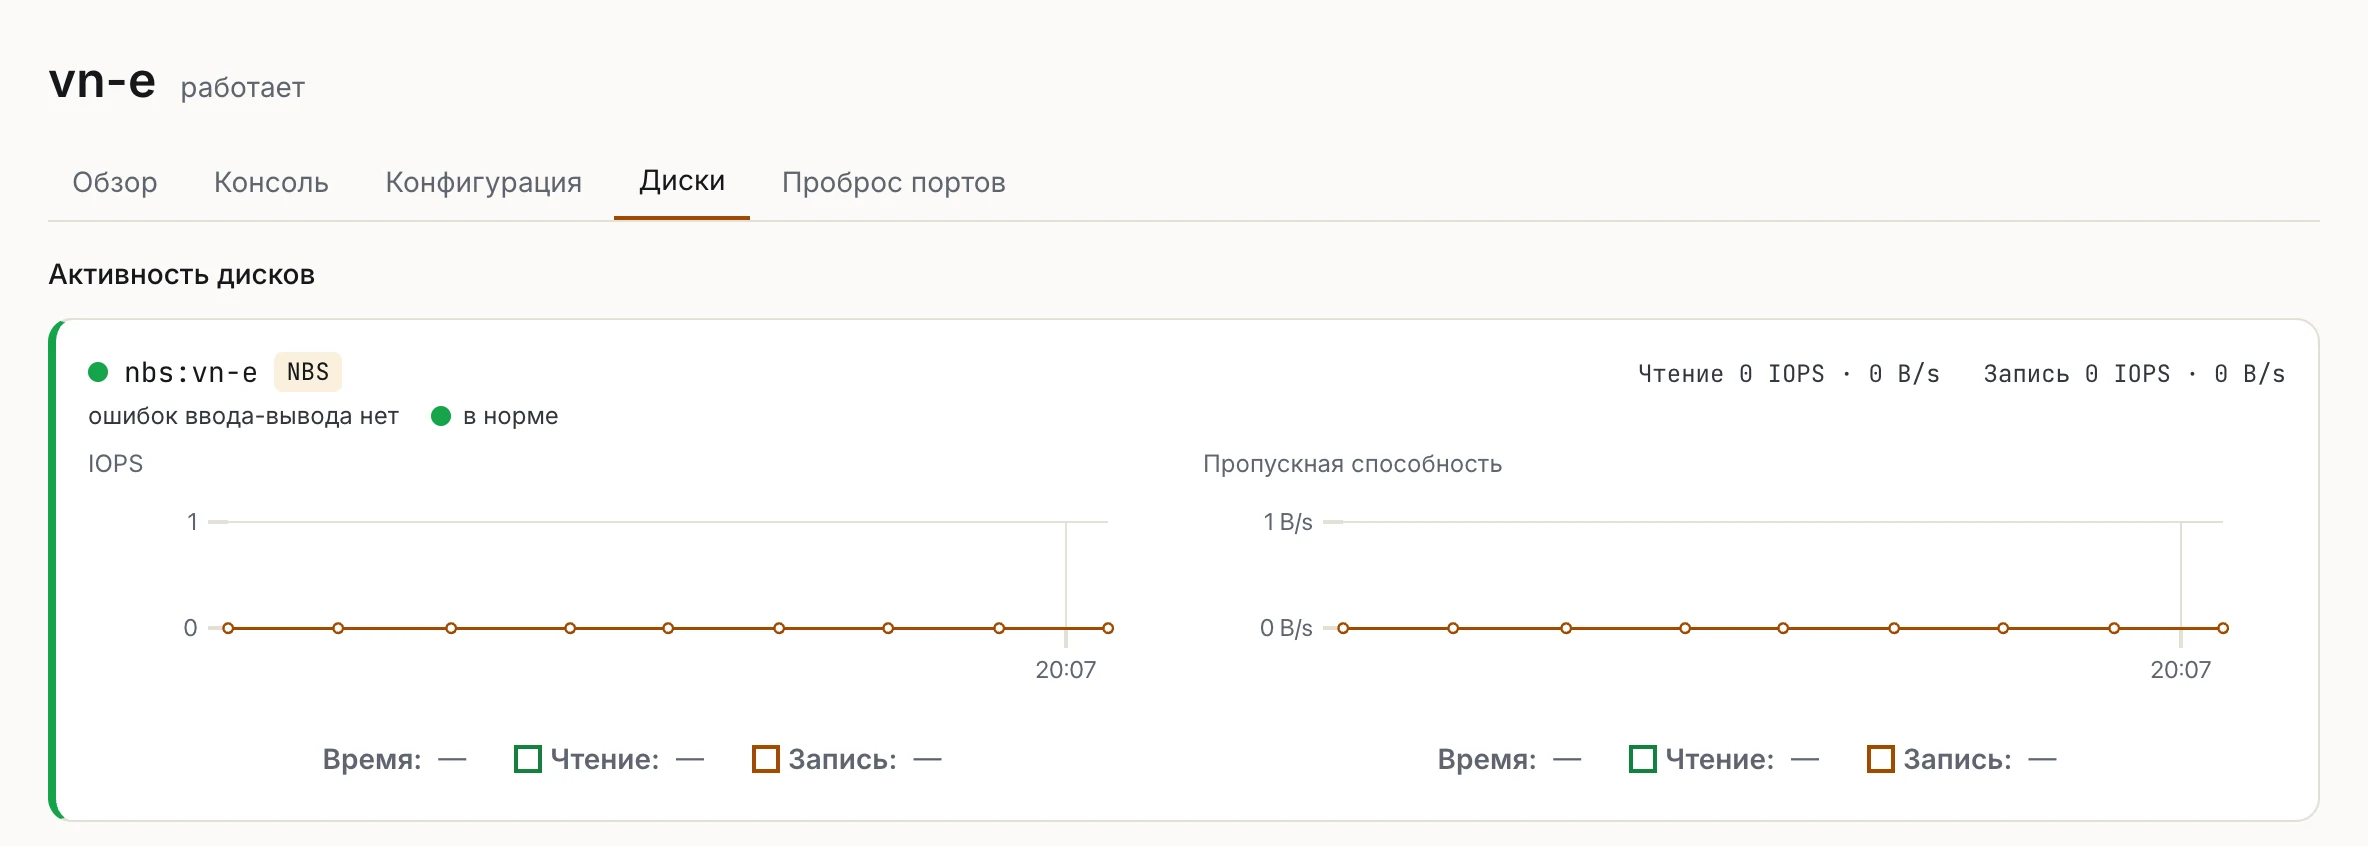
Вкладка «Диски» у vn-e: её диск, том NBS vn-e, в норме и без ошибок ввода-вывода. Машина простаивала, поэтому графики ровные.
Как пользоваться из командной строки
То же самое руками. На каждом хосте, когда реестр кластера уже поднят (как это сделать, описано в документации по кластеру):
$ insmod /lib/modules/nbs-mds.ko
$ insmod /lib/modules/nbs-cs.ko
На первом хосте создаём кластер NBS и добавляем остальные:
a$ nbs init store
nbs: NBS cluster store made (53f0...), a its first member (1730...) -- `nbs host add` the next
a$ nbs host add b
nbs: b is member 9512... -- a learner until it holds the log, then a voter while fewer than five vote
Каждый хост отдаёт NBS устройство по его идентификатору:
a$ nbs devices add part:4f7661ab-0525-4f56-9d6b-9283d322e47c
nbs: device part:4f7661ab-... of this host's chunk server, 292 MiB -- device 3 in the metadata; its cs takes it in
Потом тома:
a$ nbs volume create disk1 64
nbs: volume disk1 (1), 64 MiB
a$ nbs volume disk1
nbs: volume disk1 (1), 64 MiB, 16 chunks of 4 MiB, its own host a, detached
  replicas, chunks a host: a 16, b 16, c 16
Образы и ВМ делаются через hv:
$ hv image img /boot.raw
hv: /boot.raw: raw, a disk of 32 MiB -- onto nbs:img, 32 MiB, fresh: its zeros left out
hv: nbs:img: 32 MiB written in 0.3 s, flushed and let go of
hv: nbs:img is an image now, 32 MiB, read-only for good -- hv create <vm> image=nbs:img makes a vm of a clone of it
$ hv create v1 image=nbs:img size=64M mem=256
hv: nbs:v1 cloned from nbs:img, 64 MiB -- thin: its chunks copied as they are written
Вместо файла hv image принимает и URL. nbs status показывает участника на этом хосте, лидера и сколько чанков на трёх, двух и одной реплике. nbs io читает и пишет том прямо из командной строки, а nbsload даёт на него нагрузку.
Чего пока нет
У тома один писатель, так что общих дисков нет. Запись упирается в сеть, на гигабите это около 90 МиБ/с. Копирование при записи работает целыми чанками по 4 МиБ. Нет кодов коррекции ошибок вместо реплик, сжатия, дедупликации и шифрования на диске (каналы между хостами шифруются). Гость пока не умеет освобождать блоки через discard. Тома читает только гипервизор, сам nos смонтировать том не может. И кластер из трёх хостов переживает потерю одного, но для восстановления третьей копии ему нужен четвёртый.
Живая миграция ВМ между хостами в планах, и с NBS она проще, чем могла бы быть: диск никуда переезжать не должен.
Подробности есть в документации по NBS и в заметках о проектировании, plans/nbs.md.