vnet: одна частная сеть для ВМ на разных серверах
ВМ на разных хостах кластера nos теперь могут жить в общих частных сетях. Как vnet хранит своё состояние, как пакеты переходят между серверами по шифрованному UDP-туннелю, публичные адреса, фаерволы, что бывает при отказе хоста и как этим пользоваться.
Ещё несколько дней назад у каждого хоста в nos была своя маленькая сеть для его ВМ. Коммутатор внутри гипервизора везде раздавал одну и ту же подсеть, 10.0.100.0/24, на шестнадцать портов. В интернет машина выходила через маскарадинг на хосте, а внутрь можно было попасть только через hv forward, который пробрасывает один TCP-порт. В итоге две ВМ на разных хостах не видели друг друга, адреса у них на каждом хосте совпадали, а дать машине публичный адрес было нельзя.
Когда NBS научил диск ВМ переживать свой хост, следующей очевидной проблемой стала сеть. 15 ноября мы записали, чего хотим: ВМ на разных хостах кластера в одной частной сети, частные адреса, NAT в интернет и публичный адрес для машины, которой он нужен, например дополнительный IP или небольшая подсеть, арендованная у Hetzner. Несколько решений приняли сразу. Публичный адрес пока делается через NAT один к одному, а сам адрес внутри гостя можно будет добавить позже. По сетям ходят только IPv4 и ARP. Сетей в кластере сколько угодно, и каждая ВМ живёт в одной из них, которую выбирают при создании машины. И у каждой ВМ есть фаервол: всё входящее по умолчанию закрыто, даже из её собственной сети, всё исходящее открыто, и фаервол помнит состояние соединений.
Получилось то, что мы назвали vnet. Он состоит из трёх частей: модуля, который хранит состояние сетей на каждом хосте кластера, коммутатора в гипервизоре каждого хоста, к которому подключаются ВМ, и шифрованного UDP-туннеля между хостами.
Как это устроено
           host A                                       host B
  VM web, 10.10.0.50                           VM db, 10.10.0.51
          |                                            |
  switch: a port on lan                        switch: a port on lan
          |   \                                        ^
          |    `-- tunnel ==== UDP 39241, sealed ===== tunnel
          |
  hv0, the gateway 10.10.0.1 -- NAT -- uplink -- the internet
Сами сети живут в vnet.ko. Это отдельная группа Raft поверх реестра кластера, так же как у сервиса метаданных NBS, поэтому каждый хост держит всё состояние целиком, и все хосты в нём сходятся. В состоянии лежат сети (у каждой частная подсеть от /16 до /28, MTU и выход в интернет или его отсутствие), порты (по одному на сетевую карту ВМ, с адресом, хостом и фаерволом), публичные адреса и фаерволы кластера. Шаг apply у Raft не смотрит ни на часы, ни в реестр, поэтому каждый участник вычисляет одно и то же состояние, а раз в 64 записи участники сверяют его хеш. Участник, чей хеш разошёлся с лидерским, перестаёт отвечать, чтобы не раздавать другую картину сети.
Гипервизор на хостах с Raft не разговаривает. В нём работает небольшая задача, хранитель, которая раз в секунду спрашивает у vnet таблицу этого хоста и получает её целиком, только если в ней что-то поменялось. Когда ВМ запускается, её порт подключается через чтение, которое подтверждает лидер Raft, и лидера при этом ждут до пяти секунд.
ВМ в сети
Сеть для ВМ выбирают при её создании, через network=vnet:lan. Порт, адрес и фаервол машина получает от vnet. Свой адрес, шлюз и MTU гость узнаёт тремя путями: из командной строки ядра (ip=), по DHCP, на который коммутатор отвечает сам, и от сетевой карты virtio, которая сообщает MTU. MAC-адрес машины складывается из 02:00 и четырёх байт её IP-адреса.
Коммутатор строг в том, что пропускает. В сети кластера он передаёт только IPv4 и ARP, остальное отбрасывает, и никаких широковещательных рассылок. На ARP он отвечает сам: за шлюз MAC-адресом хоста, за ВМ той же сети её MAC-адресом, где бы эта машина ни работала. Шлюзом каждой сети служит её первый адрес, и живёт он на каждом хосте, так что ВМ всегда выходит в интернет с того хоста, где работает. Центрального маршрутизатора, с потерей которого все остались бы без связи, нет. На пакет больше MTU сети шлюз отвечает «fragmentation needed», а две разные сети никогда не видят пакетов друг друга.
Между серверами: туннель
Если машина-получатель на другом хосте, коммутатор отдаёт пакет в туннель. Каждый пакет идёт по проводу одной UDP-датаграммой:
Ethernet | IPv4, DF | UDP 39241 to 39241, checksum 0 |
  kind 1, network 3, key 4, counter 8 | the IPv4 packet, sealed | tag 16
Туннель несёт IP-пакет, а не весь Ethernet-кадр. Заголовок Ethernet принимающий хост строит сам, по своей таблице. Первый набросок был похож на Geneve, а то, что получилось, ближе к сообщению с данными у WireGuard, и разбирать приходится меньше. UDP выбрали, а не TCP-каналы, которые между хостами уже есть, потому что внутри TCP один потерянный сегмент на канале между хостами остановил бы все гостевые соединения за ним, а таймеры повторной передачи у гостей начали бы спорить с таймерами самого TCP.
Каждая датаграмма шифруется ChaCha20-Poly1305. Счётчик служит одноразовым числом (nonce), а заголовок идёт как связанные данные, так что датаграмма, у которой по дороге поменяли сеть, ключ или счётчик, не расшифруется. Ключи раздаются так, что договариваться ни о чём не нужно: каждый хост выдаёт каждому другому ключ, которым тот должен шифровать датаграммы для него. Ключ передаётся по каналу сообщений кластера, а это TLS, где обе стороны заранее знают ключи друг друга. На каждое сообщение делается новый ключ, раз в час он выдаётся заново (rekey=3600), а предыдущий хранится ещё две минуты (keylife=120), чтобы пакеты, зашифрованные прямо перед сменой, всё равно открылись. Нет гонки за то, кто начнёт первым, перезагрузка означает просто новые ключи, а хост, которого убрали из реестра, теряет свои ключи вместе с ним.
На принимающей стороне метку проверяют до того, как расшифровать хоть один байт, а окно из последних 2048 значений счётчика отбрасывает повторы и всё, что старше. Отправителя узнают по номеру ключа, а не по адресу источника. Это важно, потому что два из наших трёх хостов стоят за одним NAT, и адрес с портом, с которых пришла датаграмма, ничего надёжного об отправителе не говорят.
Ещё туннель присматривает за хостами. Раз в пять секунд он шлёт через туннель эхо каждому хосту, для которого у него есть ключ, и каждое третье эхо размером с самый большой MTU среди сетей. Если хост молчит 20 секунд, в журнал пишется строка, и у него заново просят ключ. Если маленькие эхо проходят, а большие нет, тоже пишется строка, потому что это значит, что сеть под туннелем не пропускает MTU, который дали сетям. Туннель добавляет к каждому пакету 60 байт, так что на обычном канале в 1500 байт MTU сети может быть не больше 1440. По умолчанию он 1420.
Пакеты шифруются на процессоре того гостя, который их отправил, а расшифровываются в программном прерывании приёма. С 16 ноября и то и другое идёт через ассемблер CRYPTOGAMS вместо переносимого кода на Rust. На ядре Apple M-series, где мы это мерили, датаграмма в 1400 байт теперь шифруется примерно за 1,2 мкс вместо 2,7. На x86 серверов мы пока не мерили.
Публичные адреса
Публичный адрес провайдер направляет на один хост кластера, а поставить его можно на порт ВМ на любом хосте. Обслуживает адрес тот хост, на который он направлен: его внешний интерфейс отвечает за этот адрес на ARP и объявляет его, NAT один к одному переводит адрес в частный адрес ВМ, а пакеты по туннелю уходят на тот хост, где машина работает на самом деле. Ответы идут обратно тем же путём и уходят в мир с хоста, на который направлен адрес, потому что Hetzner не даёт серверу отправлять пакеты с адреса, который на него не направлен:
in:   the world -> ex44's uplink -> NAT one to one -> hv0 -> the switch
        -> the tunnel (kind 3) -> ax41 -> the port
out:  the port -> its gateway -> the tunnel (kind 2) -> ex44 -> hv0
        -> NAT one to one -> the uplink -> the world
Сам гость видит только свой частный адрес. ВМ без публичного адреса выходит в мир через маскарадинг своего хоста, как и раньше.
Фаерволы
Сетевую карту каждой ВМ на её порту проверяет ровно один фаервол. Входящие пакеты отбрасываются, если ни одно правило их не пропускает, исходящие разрешены, а ответы на соединения самой ВМ пропускаются обратно. Правила проверяются по порядку, решает первое совпавшее, и на каждую ВМ отслеживается до 2048 потоков. Фаерволом называется именованный набор правил вроде allow in tcp 80,443, и один фаервол могут делить сколько угодно ВМ. Сети кластера используют фаерволы кластера, которые хранятся в состоянии vnet. ВМ, у которой фаервол не указан, получает default. Изменение фаервола доходит до всех хостов за секунду, и потоки, которые новые правила запрещают, обрываются. На исходящий пакет, запрещённый правилом, приходит ответ («administratively prohibited»), а не тишина, так что программа внутри ВМ сразу получает ошибку, а не ждёт таймаута.
Когда что-то ломается
Главное правило было такое: путь данных не должен зависеть от того, здоров ли Raft. Если у vnet нет лидера, пакеты продолжают ходить по последней таблице. ВМ, которая запускается в это время и чей порт уже числится за этим хостом, получает его «неподтверждённым» до возвращения лидера, а совсем новому порту приходится лидера дождаться. Если на хосте выгрузить vnet.ko, уже работающие ВМ продолжают работать, а новые в сетях кластера не запускаются, пока модуль не вернётся. Если другой хост перезагрузился или заново загрузил гипервизор, обе стороны делают новые ключи, и несколько секунд пакеты теряются. Замолчавший хост замечают по эхо. Порт, который перенесли или удалили, пока его ВМ работала, закрывается: машина продолжает работать, но ничего к ней не приходит и ничего от неё не уходит.
Две ошибки за время разработки стоит рассказать. Первую поймал фаззер. Его цель tunnel гоняет настоящие коммутаторы и туннели трёх хостов по имитации провода, который теряет, повторяет, портит, переставляет и подделывает датаграммы, а в трети прогонов два хоста ещё и стоят за NAT. Когда мы научили его переносить порт хоста посреди трафика, он нашёл одноразовое число, использованное дважды. При смене адреса хоста его запись в туннеле создавалась заново, а список уже использованных номеров ключей уходил вместе со старой записью. Пришедшее повторно сообщение с ключом принималось как новое, и его счётчик начинался снова с нуля. Для потокового шифра хуже почти ничего не бывает. Ошибка сидела в туннеле с самой первой версии, просто раньше до неё ничего не доходило: в прежних тестах адреса никогда не менялись.
Вторая проявилась только на настоящих серверах. ВМ в сети кластера вообще не запускалась, если её создали обычным способом, с папкой и vm.toml. Вспомогательная функция, которая запоминает порт коммутатора ВМ при первом запуске, писала в её конфигурацию port=, а ВМ в сетях кластера port= не принимают, потому что их портами распоряжается vnet. Это была одна из четырёх проблем, которые стенд нашёл, а ни один тест не заметил.
Всего у фаззера гипервизора 99 мутантов для фаерволов, NAT, сетей кластера, туннеля и публичных адресов. Каждый убирает одно правило, и каждый пойман. У состояния vnet своя цель в фаззере и свои 18 мутантов, а tests/vnet-test.py проверяет всё вместе на трёх nos, где место ВМ занимают пробы.
Цифры
15 ноября мы мерили это на демостенде: EX44 на собственном железе и ax41a, nos под KVM на AX41, за единственным адресом AX41 и его NAT. На каждом работала ВМ с Alpine, чей диск был клоном образа из NBS, так что машина на ax41a была гостем внутри гостя. iperf3 за 20 секунд показал 861 Мбит/с TCP от ВМ на EX44 в один поток, примерно столько гигабитный канал и пропускает, когда каждый пакет на 60 байт больше, и 833 Мбит/с в четыре потока. В обратную сторону вышло 470 Мбит/с, отправителем там была вложенная ВМ. Пинг 0,52/0,66/1,02 мс (минимум, среднее, максимум). В одну сторону ушло 11,4 миллиона датаграмм, в другую 4,2 миллиона, и туннель не потерял и не отверг ни одной. 109 не отправились, потому что у сетевой карты EX44 в тот момент было полное кольцо.
Тогда шифр ещё работал на переносимом Rust. Сегодня, после перехода на CRYPTOGAMS, мы быстро проверили тот же стенд: проба на ax41a пропинговала ВМ на EX44 20 раз из 20, по 32 датаграммы в каждую сторону, без подделок и повторов. iperf3 заново пока не гоняли.
Как пользоваться из панели
В панели управления у каждого хоста есть страница «Сети машин». Начинается она с кнопок «Создать vnet» и «Добавить хост». Дальше «Новая сеть» спрашивает имя, подсеть, MTU от 576 до 1440 (по умолчанию 1420) и есть ли у сети выход в интернет. На странице видно, на что обратить внимание, сети, порты, публичные адреса, фаерволы с их правилами и участников vnet. Порт можно перенести, удалить или сменить ему фаервол. Публичный адрес можно поставить на порт или направить на другой хост, когда провайдер начнёт маршрутизировать его туда. В фаервол правила добавляются кнопкой «Добавить правило», а две его политики, для пакетов, под которые не подошло ни одно правило, задаются в «Политиках». Каждое правило можно убрать или переместить выше или ниже в отдельной таблице правил.
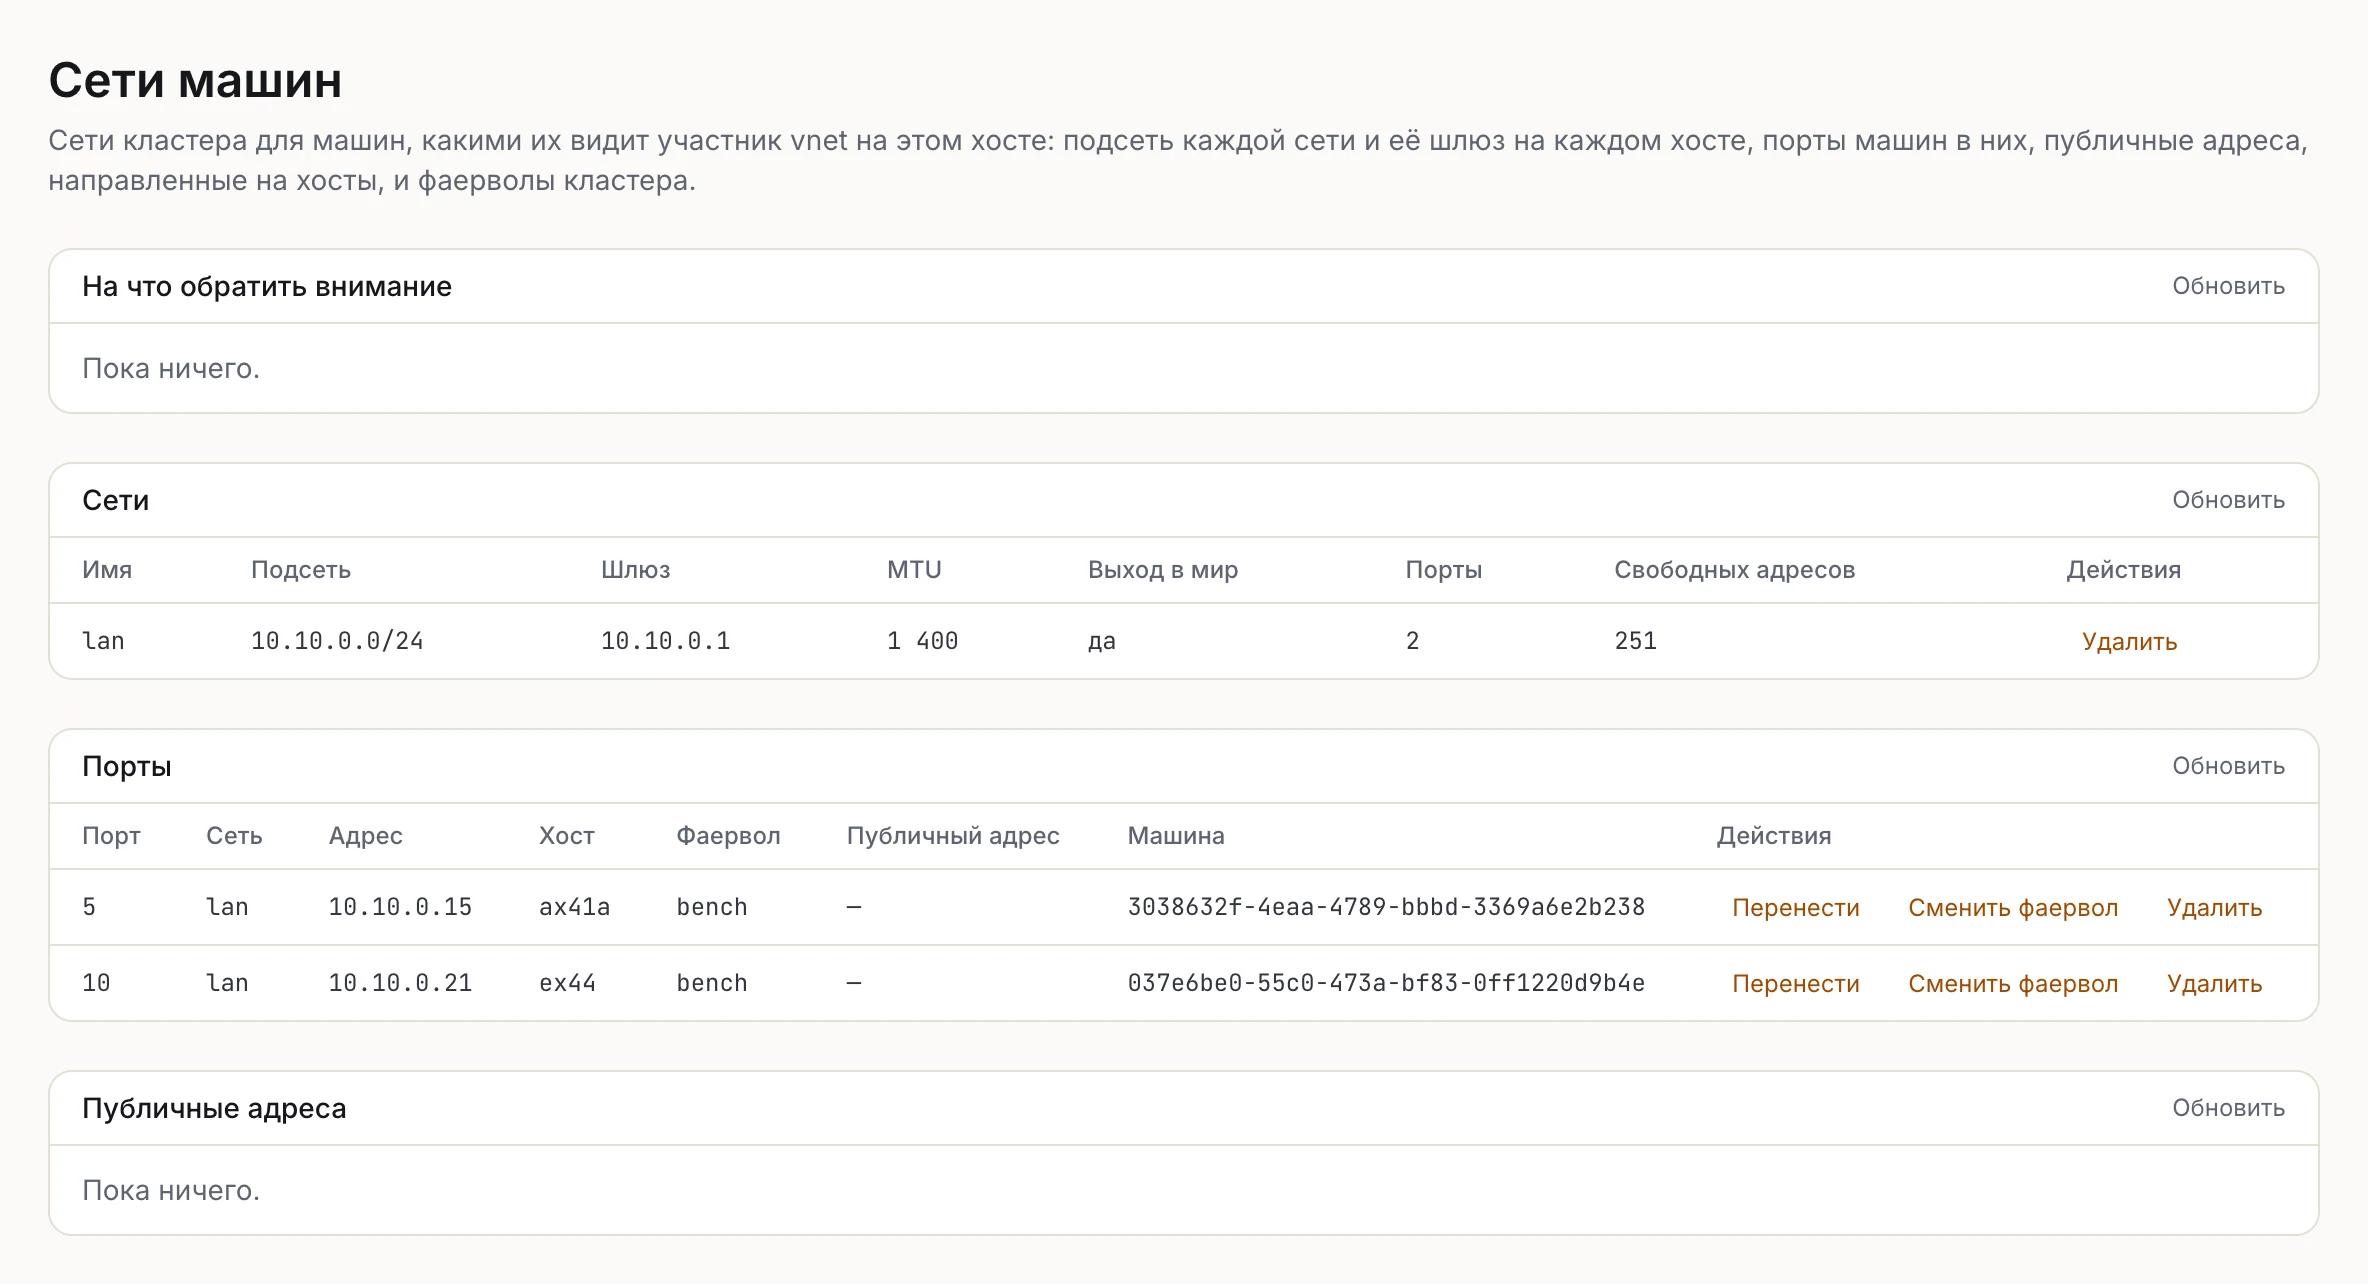
Страница «Сети машин» на EX44. В сети lan два порта, один на ax41a, другой на EX44, оба под фаерволом bench. Публичных адресов пока нет.
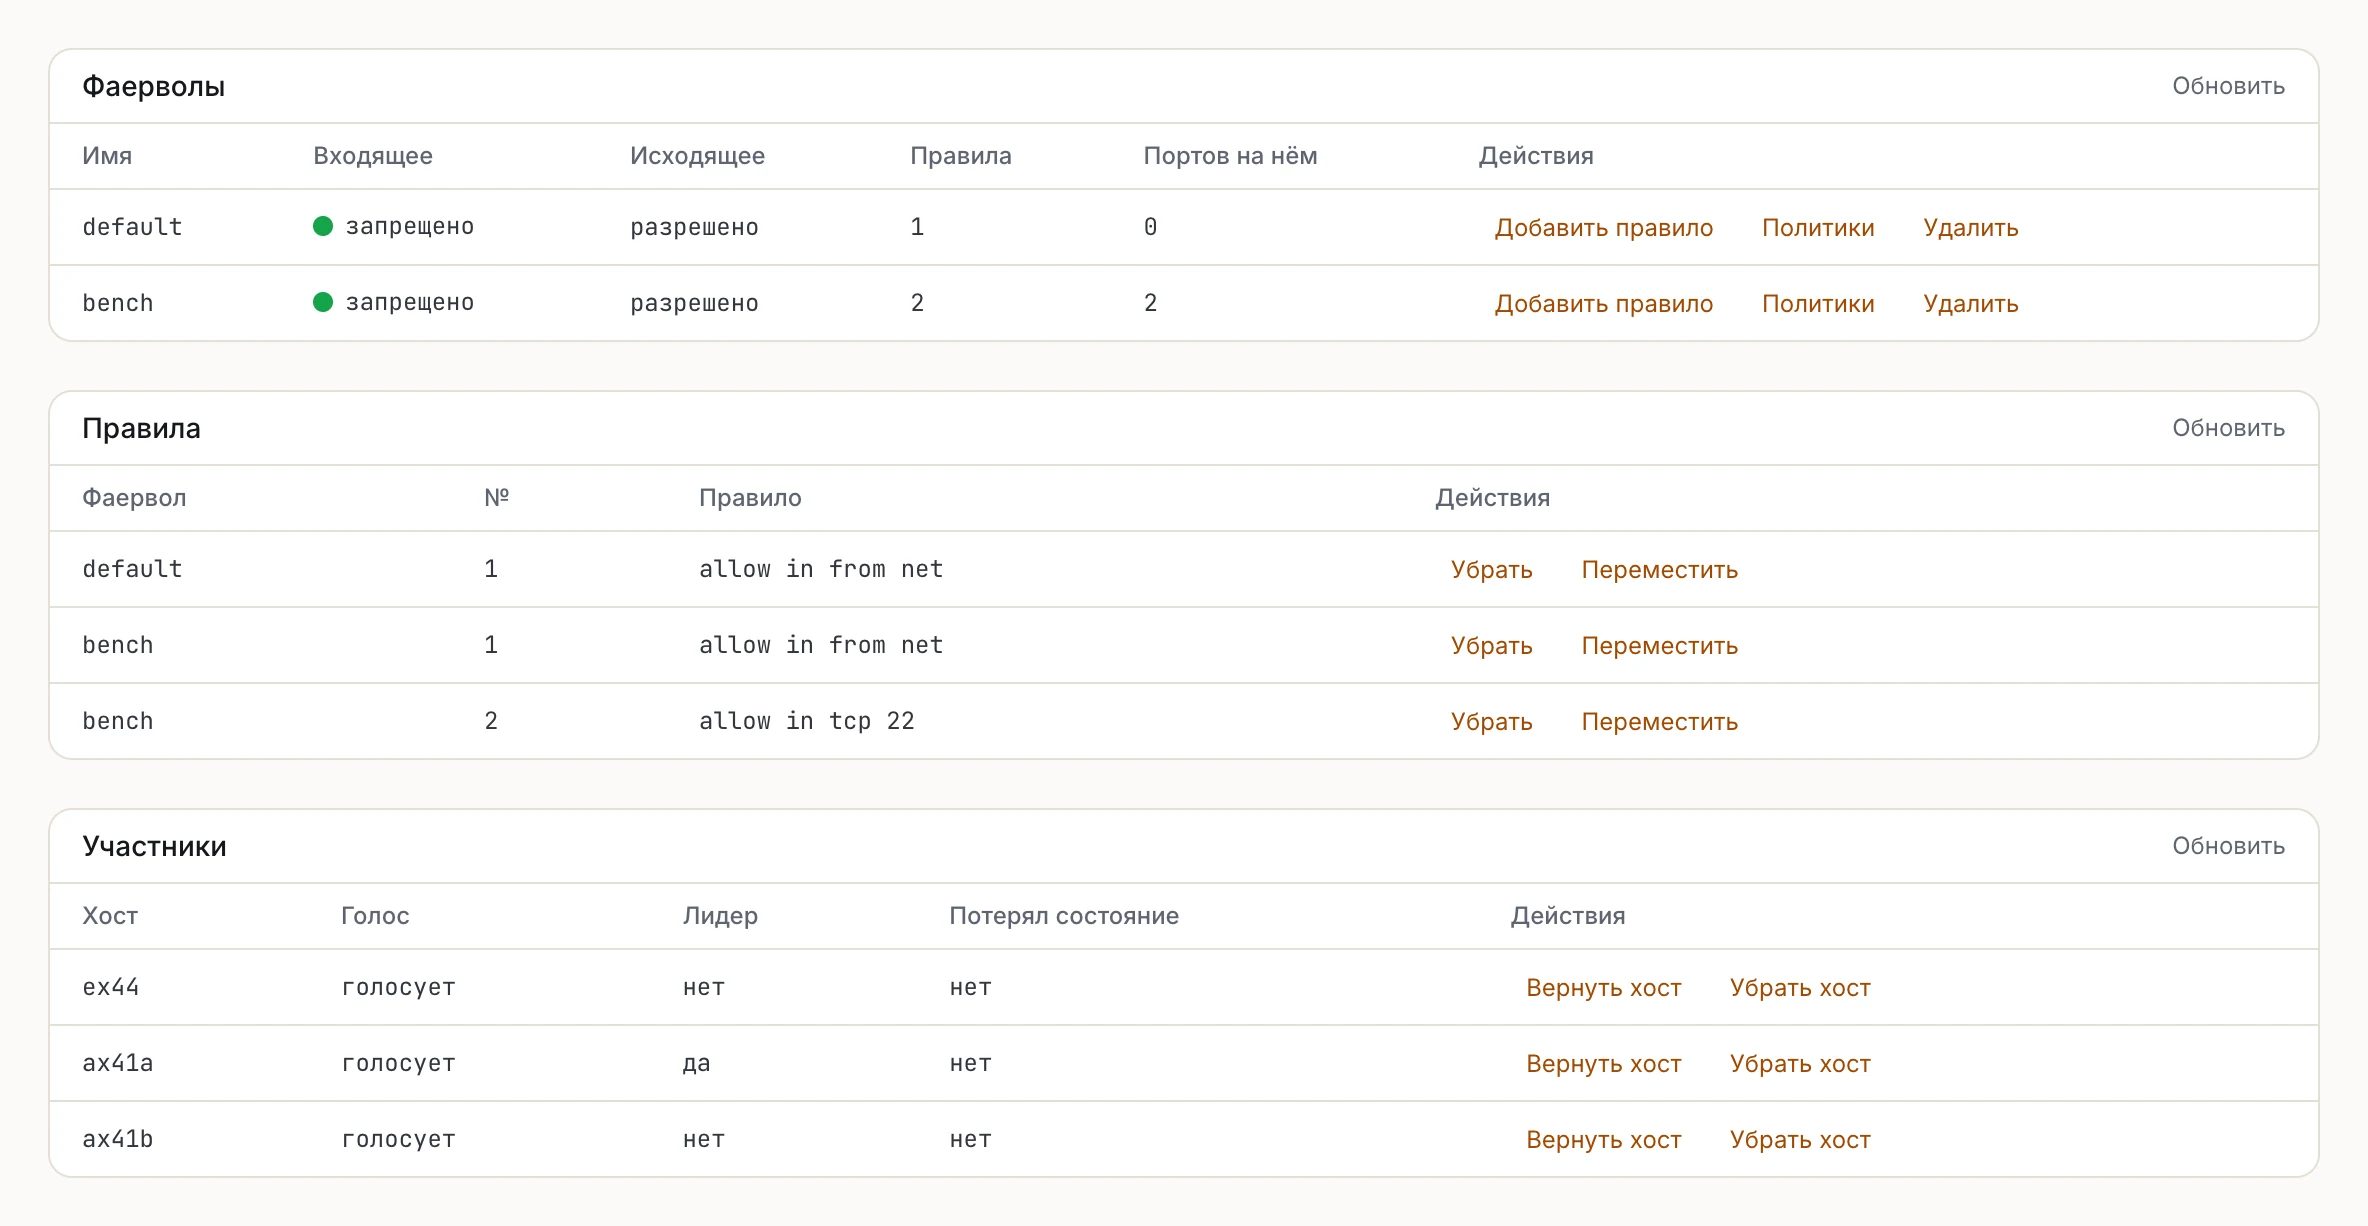
Ниже: два фаервола кластера, их правила и три участника vnet, где лидирует ax41a.
При создании ВМ в списке сетей есть и собственные сети хоста, и сети кластера, они записаны как vnet:<name>. Если выбрать сеть кластера, список фаерволов меняется на фаерволы кластера, а поле публичного адреса пропадает, потому что публичными адресами распоряжается vnet и ставятся они на порты со страницы «Сети машин».
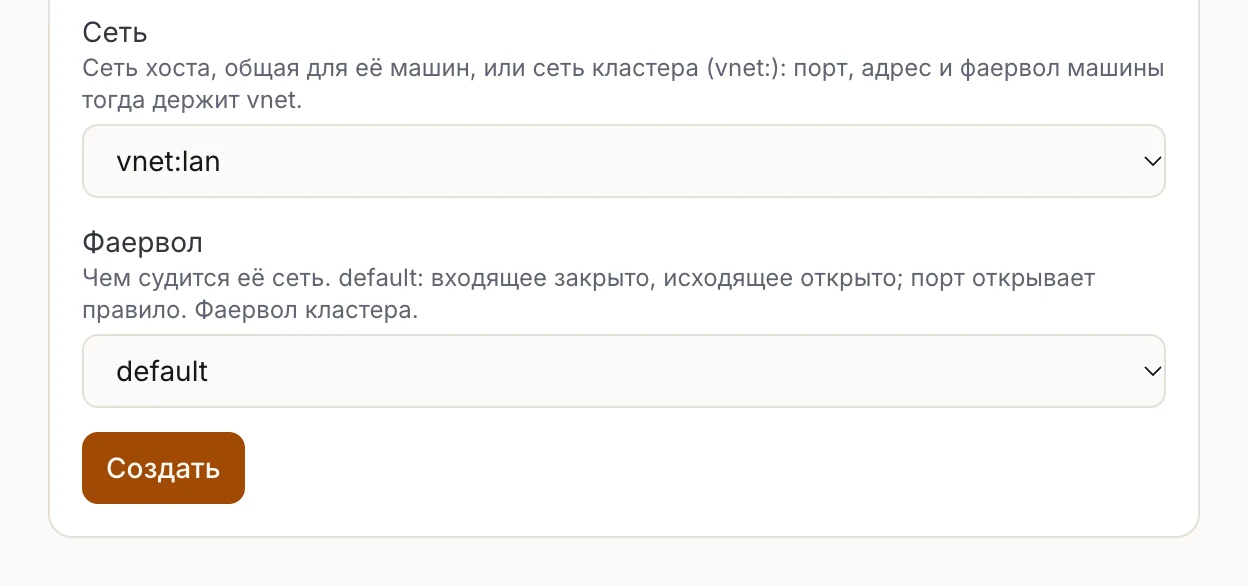
Форма новой ВМ с выбранной сетью кластера. В списке теперь фаерволы кластера, а поля публичного адреса нет.
Как пользоваться из командной строки
Перед vnet.ko должен быть поднят реестр кластера (документация по кластеру). На каждом хосте:
$ insmod /lib/modules/vnet.koНа одном из них создаём группу и добавляем остальные хосты:
$ vnet init lab
vnet: lab made
$ vnet host add b
vnet: b is member 2
Сети, одна с выходом в интернет и одна без:
$ vnet create lan 10.10.0.0/24 mtu=1400
$ vnet create dev 10.20.0.0/24 out=no
$ vnet list
ВМ в одной из них:
$ hv create web /bzImage net network=vnet:lan address=10.10.0.50 firewall=web
hv: web given port 4 on vnet:lan at 10.10.0.50, judged by its firewall web
$ hv start web
$ vnet ports
Фаерволы:
$ vnet fw default add allow in from net
$ vnet fw create web
$ vnet fw web add allow in tcp 80,443
$ vnet port firewall 4 web
Первая строка нужна почти всегда: она разрешает машинам одной сети видеть друг друга. Без неё входящий трафик закрыт даже внутри сети.
Публичный адрес, направленный на хост a, ставится на порт 4, где бы ни работала его ВМ, и снимается обратно:
$ vnet ip add 203.0.113.9 a
vnet: public address 203.0.113.9, routed to a
$ vnet ip set 203.0.113.9 4
vnet: 203.0.113.9 on port 4
$ vnet ip set 203.0.113.9 none
hv tunnel показывает каждый хост, на месте ли его ключи, когда он последний раз ответил на эхо, и сколько отправлено, принято и отброшено, с причиной для каждого отброшенного:
hv tunnel: instance 5a1c..., node 1, at 10.9.0.1:39241
  b                10.9.0.2:39241        hop known  key to it had  keys given it 2  echo answered 3 s ago, a full one 13 s ago
  sent 1873, received 1869; not sent: no key 2, no room 0, no hop 0; not taken: unknown 0, replayed 0, forged 0, stale 0; echoes answered 41
Чтобы проверить сеть до того, как загрузится хоть один гость, hv probe add p1 network=vnet:lan создаёт порт без ВМ за ним. Он отвечает на ARP, пинг и UDP на порт 7, а hv probe ping p1 <address> пингует оттуда, где была бы гостевая система.
Чего пока нет
По сетям кластера ходят только IPv4 и ARP, так что нет ни IPv6, ни широковещательных и групповых рассылок между ВМ. У ВМ одна сеть и одна сетевая карта. Пакет доставляется только на тот порт, которому адресован, поэтому ВМ, которая маршрутизирует трафик соседей, например VPN-шлюз, работать не будет. MTU сети после создания не меняется. TCP идёт через туннель по одному пакету размером с MTU, тогда как внутри одного хоста большая отправка передаётся целиком. В кластере не больше 16 хостов, а у коммутатора хоста не больше 16 портов. В планах публичный адрес внутри самого гостя, несколько сетей на ВМ, IPv6, переезжающие адреса (failover IP) через API Hetzner и живая миграция ВМ между хостами, для которой понадобятся и vnet, и NBS.
Полное описание есть в документации по vnet, а проект и его история в plans/vnet.md.